
“知网查重到底是怎么工作的?”这个问题看起来技术性很强,但搞懂了它,你就知道为什么有些降重方法有用、有些纯属浪费时间。
第一层:字符匹配(最基础)
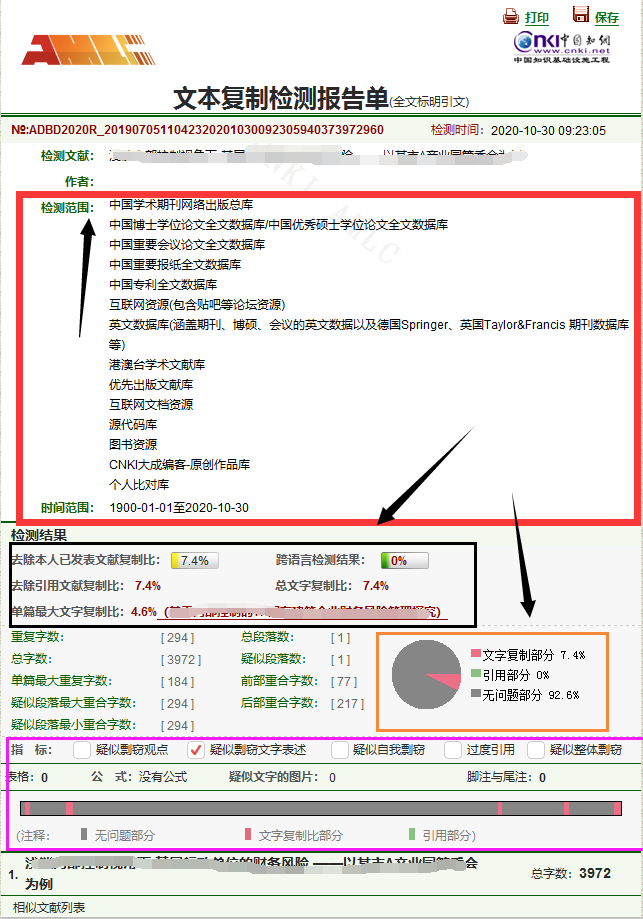
系统把你的论文切分成短语,丢掉常见停用词(的、了、是这类),然后拿每个短语去和参考数据库做比对。参考库通常包括当前和归档的网页内容、之前提交的学生论文、授权的期刊和会议论文。输出是一个相似度指数——你的文本中与语料库中某处有可检测匹配的百分比。
这一层对应的是知网的连续13字符触发机制。维普更敏感,连续8到10字符就标红。万方宽松一些,10到12字符。
第二层:语义向量比对
2027年升级后,系统进一步引入上下文语义相似度计算。系统通过NLP模型判断你的核心语义和原文是否高度一致,即使字面改了、同义词换了,语义层重复照样标浅红。
第三层:跨语言比对
系统将你的论文翻译成对应外文,再和该语种数据库进行比对。依托神经机器翻译和跨语言嵌入技术,能直接识别不同语种间的抄袭行为。
最重要的认知:相似度分数不是抄袭判决**
这类软件的相似度指数只是一个信号,不是一个结论。高相似度可能来自正确引用和标注的材料、共享的参考文献列表、学科通用的方法学语言,或者手稿与作者自己以前发表的作品匹配。Turnitin自己的产品指南就明确说过:相似度工具“不判定是否发生了抄袭”——它是用来支持审阅者自己的判断,而不是替代它。