
“我把‘经济发展非常迅速’改成了‘经济成长十分快速’,为什么还是被标红了?”
这个问题在2026年越来越普遍。原因很简单:现在的查重系统早就不是“数你抄了几个字”那么简单了。
第一步:文本碎片化
系统先把你的论文切成像素级文本碎片,和库里文献做滑动窗口比对,超阈值的片段标红。这一步是字面层面的匹配,也是老一套“换同义词”能骗过的层面。
第二步:语义向量比对
但接下来系统会叠加一层语义向量比对,把“换皮不换骨”的洗稿捞出来。你觉得自己改了——字面确实不一样了——但系统通过NLP模型判断你的核心语义和原文高度一致,照样标浅红或计入相似度。
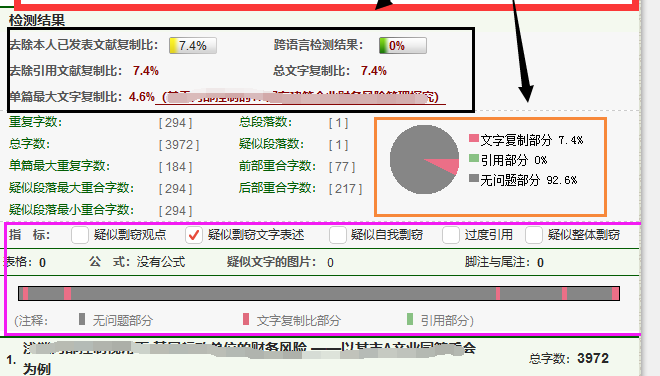
知网采用的是“滑动窗口+语义指纹+局部相似度聚合”的复合模型。窗口可能不是固定的13字符,而是动态阈值、多特征加权的综合智能系统,能识别同义词替换和语义重复。
第三步:格式解析
引用格式错、参考文献列表崩了、表格里的文字被当正文扫,这些都会导致本该绿的部分变红。参考文献全红,90%是因为格式不标准导致系统没认出来,不是你真的抄了。
所以到底怎么改才有用?
有效降重得改句式主干+加个人数据或案例,不是数着字数改。最简单的测试方法:把改完的句子念给你室友听,问他“这句话你能在别的论文里找到一模一样的说法吗?”如果他说“好像在哪见过”,那大概率语义层还是重复的。