
“我把英文文献翻译成中文,再稍微改改,知网查得到吗?”这个问题在2026年有了明确答案:查得到,而且精度很高。
跨语种查重是怎么实现的?
现在主流的查重系统,包括知网VIP5.3以上版本,都已经训练了跨语言比对的数据库。系统会先将你的论文翻译成对应外文,再和该语种数据库进行比对。知网依托神经机器翻译和跨语言嵌入技术,能直接识别不同语种间的抄袭行为。你可以理解为:系统把你的中文论文“翻译回去”,然后拿翻译后的英文去和原始英文文献比对,字面虽然不完全一样,但语义层面的匹配根本逃不掉。
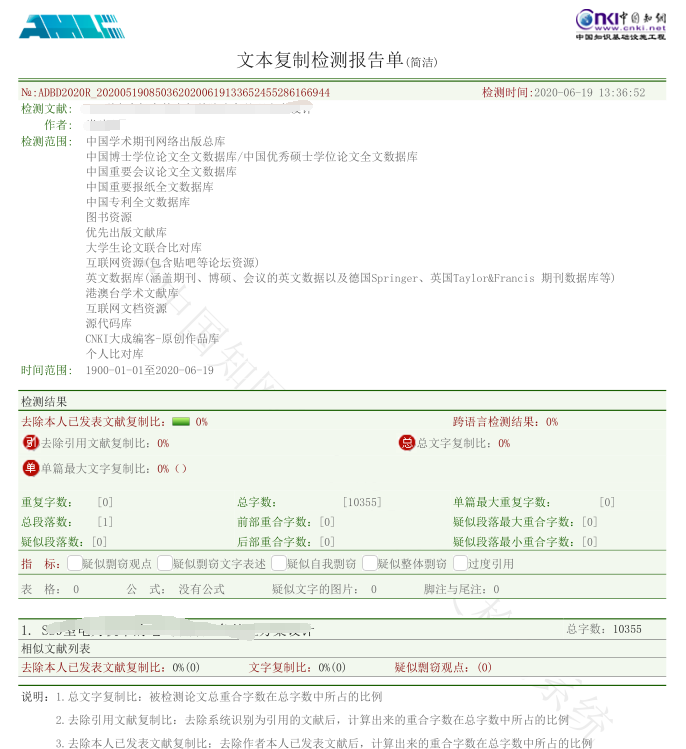
“中译英再翻译回来”的套路为什么失效?
有人想得更“聪明”——先把中文翻译成英文,再把英文翻译回中文,形成一个新的中文版本,以为这样就“洗”掉了原文。这个逻辑在技术上是行不通的。2026年升级后,系统进一步引入上下文语义相似度计算,单纯调整语序或同义词替换不再有效。就算翻译来回倒腾,核心逻辑和数据没变,系统照样判定违规。
正确做法是什么?
引用外文内容时,采用“翻译+句式重组”的模式。翻译完后调整句式结构,将核心术语替换,补充个人观点与分析,避免直接套用原文逻辑。同时,引用外文内容必须规范标注来源,确保引文格式与参考文献对号入座。翻译是理解文献的手段,不是规避查重的工具。