
先看一组真实数据:同一篇论文,知网30%,万方可能19%,维普可能41%,Paper系窜到45%也正常,极端情况能差出10%-20个百分点。这不是系统坏了,是底层逻辑本来就不一样。
原因一:数据库覆盖范围不同
知网覆盖国内外学术期刊、学位论文、会议论文、互联网资源等,对国内学术文献的覆盖尤为广泛,还有独家的“大学生联合比对库”和“学术论文联合比对库”。维普以期刊为主,网络资源覆盖较弱。万方侧重国内期刊,学位论文收录更薄。Paper系主要靠爬百度文库、知乎、网页,学术库是残缺的。
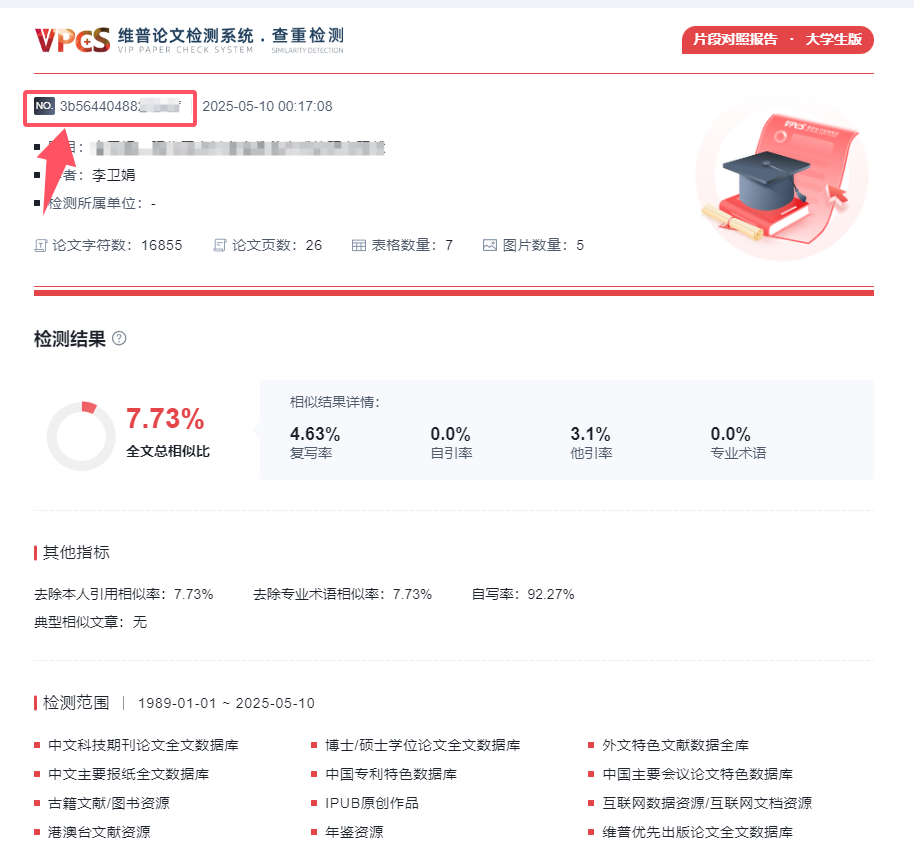
你抄的那段话,如果只存在于知网库里,万方根本看不见,知网一跑就红。
原因二:算法阈值和检测粒度完全不同
知网:连续13字符相同+语义模糊比对,5%阈值以下不检测。维普:连续8-10字符重复标红,对同义词替换和语序调整都敏感,算法最严格。万方:连续10-13字符标红,偏句级匹配,算法宽松。
同一句“本研究采用问卷调查法收集数据”,知网可能放你一马(术语+上下文),维普可能标红(关键词序列撞车),万方可能不标(库里没这句)。
原因三:格式解析和文档处理差异
免费系统和正式系统对PDF和Word的解析能力不同。如果你的文档格式混乱,系统在解析文本时可能出错,把脚注、尾注、参考文献列表的内容误判为正文,从而拉高重复率。
原因四:数据库更新频率不同
你自查的时间和学校查重的时间可能差了几天甚至几周,这期间系统数据库可能更新了新增的文献,导致重复率出现波动。
所以到底该怎么办?
别再纠结“哪个系统准”了。唯一准的是学校指定系统同版本。指定知网PMLC就死磕知网,指定维普机构端就中稿用维普自费版。留5%余量按学校指定系统的红线压,这才是真保险。